
Di era digital yang serba cepat ini, data sering kali digambarkan sebagai “minyak baru”—komoditas yang sangat berharga yang, jika diolah dengan benar, dapat memberikan wawasan luar biasa dan mendorong keputusan strategis yang cerdas. Dari perusahaan multinasional hingga kebijakan publik, semua bergantung pada analisis data untuk memprediksi tren, mengoptimalkan kinerja, dan memahami perilaku manusia. Namun, ada satu kenyataan pahit yang sering diabaikan: data hanyalah sekumpulan angka, teks, atau fakta mentah yang diam. Kekuatannya yang sebenarnya tidak terletak pada jumlah data yang dikumpulkan, melainkan pada bagaimana manusia memberinya makna. Sayangnya, di sinilah proses tersebut paling rawan runtuh. Memberikan makna pada data, atau yang kita kenal sebagai interpretasi data, adalah jembatan yang menghubungkan kebenaran statistik dengan tindakan nyata, tetapi b jembatan ini sering kali rapuh karena kesalahan interpretasi yang tidak disadari.
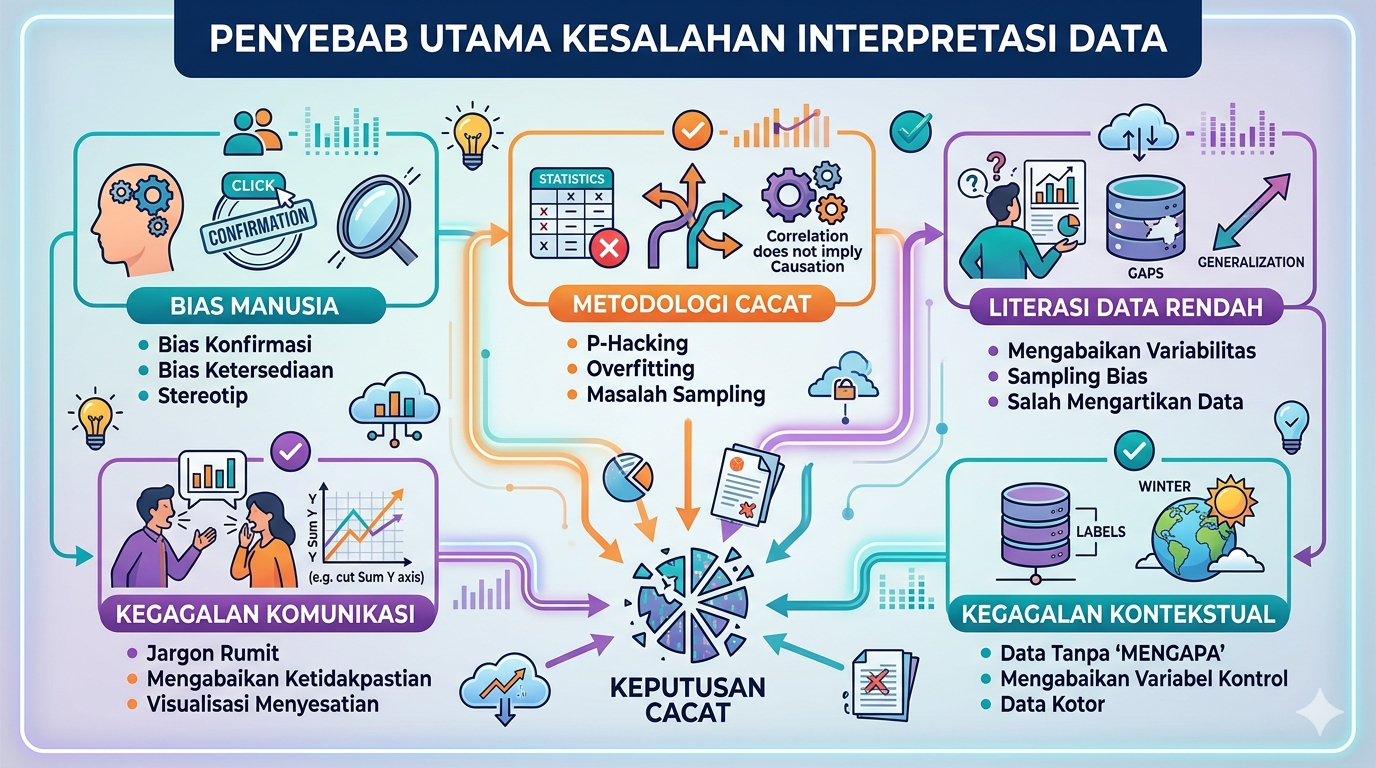
Kesalahan dalam interpretasi data bukan hanya masalah teknis kecil di departemen analitik; itu adalah kegagalan sistematis yang dapat memiliki konsekuensi dunia nyata yang menghancurkan. Bayangkan sebuah perusahaan farmasi yang salah menafsirkan data uji klinis, yang menyebabkan peluncuran obat dengan efek samping yang fatal. Atau pikirkan pemerintah yang salah membaca tren ekonomi, yang mengakibatkan kebijakan fiskal yang memicu resesi. Masalahnya jarang terletak pada datanya sendiri, yang biasanya jujur apa adanya. Masalahnya terletak pada lensa yang digunakan manusia untuk melihat data tersebut. Kita sering kali datang ke meja analisis dengan harapan, bias, dan keterbatasan kognitif, yang semuanya bertindak sebagai filter yang mendistorsi kebenaran kaku dari data mentah menjadi narasi yang kita inginkan atau kita takuti.
Lalu, apa yang sebenarnya terjadi di balik layar analisis yang gagal? Mengapa profesional berpengalaman pun bisa jatuh ke dalam jebakan yang sama? Penyebab utamanya jarang berupa satu kesalahan teknis tunggal, melainkan perpaduan rumit antara faktor manusia, metodologi yang cacat, dan kegagalan sistematis untuk melihat data dalam konteks yang benar. Memahami mengapa kita sering salah membaca data adalah langkah pertama dan paling krusial untuk mencegah kesalahan dalam interpretasi data di masa depan. Artikel ini akan mengupas tuntas berbagai lapisan penyebab utama kegagalan interpretasi ini, mulai dari bias kognitif yang melekat pada cara kerja otak kita, metodologi statistik yang sering disalahgunakan, hingga pentingnya literasi data yang sering kali diabaikan. Kita akan menjelajahi mengapa kesalahan-kesalahan ini terjadi dan, yang lebih penting, bagaimana kita bisa membangun filter yang lebih baik untuk melihat kebenaran yang sesungguhnya di balik angka-angka tersebut.
Bias Manusia: Musuh Tersembunyi dalam Meja Analisis
Penyebab paling utama dan paling sulit dideteksi dari kesalahan dalam interpretasi data adalah bias kognitif manusia. Bias-bias ini bukanlah tanda ketidaktahuan atau kurangnya keahlian; sebaliknya, mereka adalah jalan pintas mental yang digunakan otak kita untuk memproses informasi dalam jumlah besar dengan cepat. Namun, dalam konteks analisis data yang menuntut objektivitas ketat, jalan pintas ini sering kali menyesatkan.
Bias Konfirmasi: Mencari Apa yang Kita Inginkan
Salah satu bias yang paling umum adalah bias konfirmasi. Ini terjadi ketika kita secara tidak sadar hanya mencari, memperhatikan, atau memberikan bobot lebih pada data yang mendukung keyakinan atau hipotesis awal kita, sambil mengabaikan atau meremehkan data yang bertentangan. Bayangkan seorang manajer pemasaran yang yakin bahwa kampanye iklan baru mereka sukses besar. Saat melihat data, dia mungkin akan fokus pada metrik yang menunjukkan peningkatan, seperti “klik”, dan mengabaikan metrik yang menunjukkan kegagalan, seperti “konversi penjualan yang rendah”. Bias konfirmasi bertindak sebagai filter yang mendistorsi realitas data menjadi narasi yang nyaman bagi kita, yang sering kali menyebabkan kesalahan dalam interpretasi data karena kita gagal melihat gambar yang utuh.
Bias Ketersediaan dan Bias Narasi
Selain bias konfirmasi, bias ketersediaan juga sering berperan. Kita cenderung memberikan bobot lebih pada informasi yang paling mudah diingat atau paling baru kita dengar, daripada pada data historis yang lebih lengkap. Dalam analisis tren, ini bisa menyebabkan generalisasi berlebih berdasarkan kejadian terbaru yang ekstrem. Ada juga bias narasi, di mana otak kita secara alami mencoba menganyam sekumpulan fakta kaku menjadi sebuah narasi atau cerita yang logis. Dalam analisis data, ini bisa berbahaya karena kita mungkin secara tidak sadar menciptakan hubungan sebab-akibat yang tidak ada hanya untuk membuat data tersebut “berbicara” dalam bentuk cerita yang mudah dipahami.
Heuristik dan Stereotip dalam Pengolahan Data
Penggunaan heuristik, atau aturan praktis mental, juga dapat menyebabkan kesalahan fatal. Heuristik membantu kita membuat keputusan cepat, tetapi sering kali didasarkan pada stereotip atau asumsi yang terlalu disederhanakan yang tidak berlaku untuk kumpulan data yang kompleks. Misalnya, mengasumsikan bahwa pola perilaku satu kelompok demografis akan sama di semua wilayah dapat menyebabkan generalisasi yang salah. bias kognitif manusia adalah musuh tersembunyi yang selalu ada di meja analisis, yang jika tidak disadari dan dikelola, akan secara konsisten menyebabkan kesalahan dalam interpretasi data karena kita melihat data bukan sebagaimana adanya, melainkan sebagaimana kita inginkan atau bayangkan.
Mengelola Bias untuk Interpretasi yang Lebih Baik
Meskipun kita tidak bisa sepenuhnya menghilangkan bias, kita bisa mengelolanya. Langkah pertama adalah kesadaran. Mengetahui bahwa bias-bias ini ada memungkinkan kita untuk mendekati analisis dengan sikap skeptis diri. Langkah kedua adalah menerapkan metodologi yang disiplin. Ini bisa melibatkan pembuatan hipotesis sebelum melihat data, menggunakan teknik analisis blind di mana analis tidak mengetahui hipotesisnya, atau mendorong anggota tim untuk berperan sebagai “advokat setan” yang bertugas untuk menantang kesimpulan. Tanpa disiplin metodologis untuk melawan bias manusia yang melekat, kesalahan dalam interpretasi data hampir tidak dapat dihindari, seberapa canggih pun alat analisis yang digunakan.
Baca juga: Interpretasi Data: Skill Wajib di Era Digital!
Metodologi yang Cacat: Ketika Statistik Disalahgunakan
Metodologi yang cacat atau penggunaan metode statistik yang salah adalah penyebab utama lainnya dari kegagalan interpretasi. Statistik adalah alat yang sangat kuat, tetapi seperti alat kuat lainnya, jika disalahgunakan, statistik dapat menyebabkan kerusakan besar. Kesalahan dalam interpretasi data sering terjadi ketika kita mengabaikan asumsi statistik, memilih metode yang tidak tepat, atau gagal memahami batas-batas alat yang kita gunakan.
Correlation is Not Causation: Jebakan Terbesar
Jebakan metodologis yang paling terkenal dan paling sering menjatuhkan analis adalah mengasumsikan bahwa korelasi berarti sebab-akibat. Hanya karena dua variabel bergerak bersamaan tidak berarti satu variabel menyebabkan variabel lainnya. Misalnya, data mungkin menunjukkan korelasi kuat antara penjualan es krim dan tenggelam di laut. Namun, menyimpulkan bahwa makan es krim menyebabkan tenggelam adalah kesalahan fatal. Variabel ketiga yang tidak diukur, yaitu cuaca panas, mempengaruhi kedua variabel tersebut (masalah confounding variables). Gagal membedakan antara hubungan statistik (korelasi) dan mekanisme sebab-akibat yang nyata adalah penyebab utama generalisasi yang cacat dan kesalahan dalam interpretasi data yang sering kali berujung pada keputusan kebijakan yang salah.
Masalah Sampling dan Generalisasi yang Berlebih
Faktor sampling juga sering diabaikan. Jika sampel yang digunakan tidak representatif dari populasi yang lebih luas, kesimpulan yang diambil akan cacat. Generalisasi berlebih berdasarkan sampel yang terlalu kecil atau bias dapat menyesatkan. Kesalahan dalam interpretasi data sering kali berakar pada kegagalan untuk memahami apakah sampel mencerminkan keragaman populasi yang sebenarnya.
Overfitting dan P-Hacking: Memanipulasi Statistik
Dalam dunia analisis data modern, ada juga jebakan yang lebih canggih seperti overfitting dan p-hacking. Overfitting terjadi ketika sebuah model statistik terlalu kompleks dan “menghafal” pola spesifik dalam data pelatihan, termasuk “kebisingan” atau fluktuasi acak. Model semacam itu akan terlihat sangat akurat pada data pelatihan tetapi akan gagal total pada data baru, yang mengarah pada kesalahan dalam interpretasi data karena analis mengira modelnya sangat kuat. Ada juga p-hacking, yaitu praktik memanipulasi data atau analisis sampai nilai p-value yang signifikan secara statistik (p < 0,05) ditemukan. Ini adalah kegagalan etika dan metodologis yang menyebabkan penemuan ilmiah yang tidak dapat direplikasi.
Mengabaikan Konteks dan Asumsi Statistik
Kegagalan metodologis sering terjadi ketika kita mengabaikan konteks data. Statistik yang terlihat signifikan dalam ruang hampa bisa jadi tidak bermakna atau bahkan menyesatkan dalam konteks dunia nyata. Tanpa interpretasi kontekstual yang kuat, kesalahan dalam interpretasi data dapat terjadi karena analis tidak memahami “mengapa” di balik “berapa”. Setiap uji statistik memiliki asumsi yang harus dipenuhi, seperti distribusi normal atau homogenitas varians. Mengabaikan asumsi-asumsi ini hanya untuk mendapatkan hasil yang “menarik” adalah metodologi yang cacat dan akan secara konsisten menyebabkan kesalahan fatal dalam interpretasi dan pengambilan keputusan.
Pentingnya Metodologi yang Disiplin
Menggunakan metodologi yang CACAT akan secara konsisten menyebabkan kesalahan dalam interpretasi data, seberapa besar pun jumlah data yang dikumpulkan. Statistik bukanlah mantra yang memberikan kebenaran mutlak; ia adalah alat yang membutuhkan keahlian, integritas, dan pemahaman yang mendalam tentang konteks. Untuk menghindari kesalahan-kesalahan metodologis ini, analis harus dilatih secara formal dalam statistik, selalu memvalidasi asumsi, bersikap jujur tentang batas-batas alat mereka, dan selalu menginterpretasikan hasil dalam konteks realitas dunia nyata yang lebih luas.
Literasi Data yang Rendah: Generalisasi dan Distorsi Makna
Di era di mana data ada di mana-mana, kemampuan untuk membaca, memahami, membuat, dan mengomunikasikan data sebagai informasi—yang dikenal sebagai literasi data—telah menjadi keterampilan yang fundamental. Rendahnya literasi data di antara analis, pengambil keputusan, dan masyarakat umum adalah penyebab utama generalisasi yang cacat dan kesalahan dalam interpretasi data yang meluas.
Mengapa Literasi Data Itu Penting
Literasi data yang rendah menyebabkan kegagalan dalam mengajukan pertanyaan kritis tentang data. Analis dengan literasi data yang rendah mungkin akan menerima data mentah apa adanya, tanpa mempertanyakan bagaimana data tersebut dikumpulkan, apakah sampelnya representatif, atau apakah metrik yang digunakan benar-benar mengukur apa yang ingin mereka ukur. Ini secara langsung mengarah pada generalisasi yang cacat dan kesalahan dalam interpretasi data karena proses analisisnya sendiri didasarkan pada fondasi yang rapuh. Literasi data yang rendah juga menyebabkan distorsi makna saat temuan data dikomunikasikan kepada pengambil keputusan. Tanpa pemahaman yang kuat tentang nuansa statistik, istilah teknis disalahartikan, dan peringatan tentang ketidakpastian data diabaikan.
- Generalisasi yang Salah: Sampel vs Populasi
Generalisasi yang salah adalah salah satu bentuk distorsi makna yang paling umum dan berbahaya akibat rendahnya literasi data. Berikut adalah beberapa poin yang sering diabaikan: - Mengabaikan Variabilitas: Seringkali kita fokus pada nilai rata-rata (mean) dan mengabaikan penyebaran data (standard deviation). Rata-rata pendapatan yang tinggi di sebuah wilayah tidak berarti semua orang kaya; mungkin ada ketidaksetaraan yang ekstrem. Kegagalan memahami konsep variabilitas statistik menyebabkan generalisasi yang salah tentang populasi.
- Sampling Bias: Kegagalan untuk mengenali bahwa sampel yang digunakan tidak representatif. Generalisasi yang berlebihan berdasarkan sampel kecil atau bias dapat menyesatkan. Kesalahan dalam interpretasi data sering kali berakar pada asumsi yang salah tentang generalisasi.
- Non-Response Bias: Mengabaikan data yang hilang dari kelompok tertentu yang memilih untuk tidak berpartisipasi, yang dapat mendistorsi hasil.
- Generalisasi ke Konteks yang Berbeda: Mengasumsikan bahwa pola data yang ditemukan dalam satu konteks (seperti wilayah atau waktu) akan berlaku untuk konteks yang berbeda, tanpa bukti yang kuat.
Literasi Data sebagai Filter Terhadap Misinformasi
Rendahnya literasi data membuat kita rentan terhadap distorsi makna dan misinformasi. Interpretasi yang benar menuntut batasan yang jelas. Tanpa keterampilan literasi data, kita tidak bisa mengajukan pertanyaan kritis, memahami nuansa metodologis, atau mengenali generalisasi yang salah. Untuk mengatasi masalah ini, literasi data harus diajarkan di sekolah, dan literasi data harus ditingkatkan dalam organisasi sebagai bagian dari budaya kerja. Dengan literasi data yang lebih baik, kita dapat menciptakan filter yang lebih kuat terhadap generalisasi yang cacat dan membangun dasar yang lebih kuat untuk pengambilan keputusan berbasis data yang autentik, sehingga mengurangi frekuensi kesalahan dalam interpretasi data yang merugikan.

Kegagalan Komunikasi: Ketika Data Tidak “Berbicara” dengan Benar
Tantangan utama dalam analisis data bukan hanya pada proses teknis, tetapi pada bagaimana temuan tersebut dikomunikasikan. Kegagalan komunikasi adalah penyebab utama kegagalan interpretasi, di mana interpretasi yang benar tidak sampai atau disalahartikan oleh audiens. Interpretasi yang tuntas menuntut peneliti untuk menjadi “instrumen utama” yang mampu berempati dan memahami perspektif mendalam dari para partisipan.
Kesenjangan Antara Analis dan Pengambil Keputusan
Kesalahan dalam interpretasi data sering terjadi karena adanya kesenjangan komunikasi antara analis data yang teknis dan pengambil keputusan yang non-teknis. Analis sering menggunakan jargon statistik yang rumit yang tidak dipahami oleh audiens mereka. Interpretasi yang benar membutuhkan bahasa yang objektif dan menghindari kata sifat yang bersifat emotif atau berlebihan. Gunakan kata kerja yang menunjukkan analisis, seperti “menandakan”, “mengindikasikan”, atau “berkontribusi pada”. Kegagalan menerjemahkan temuan teknis menjadi bahasa bisnis yang jelas menyebabkan pengambil keputusan salah menafsirkan nuansa temuan, yang menyebabkan keputusan kebijakan publik yang cacat.
Masalah Komunikasi dalam Interpretasi
Kegagalan komunikasi adalah penyebab utama generalisasi yang salah. Poin-poin berikut adalah masalah utama:
- Mengabaikan Ketidakpastian: Analis sering gagal mengomunikasikan batas-batas data dan ketidakpastian statistik (seperti margin of error). Kegagalan menafsirkan data kebangagiaan materi sebagai kebangagiaan psikologis menyebabkan pengambil keputusan mengabaikan peringatan tersebut, yang menyebabkan generalisasi yang salah dan keputusan yang salah.
- Penyajian Visual yang Menyesatkan: Penggunaan grafik yang dirancang untuk membingungkan atau menonjolkan tren tertentu secara tidak jujur (misalnya, mengubah skala sumbu Y secara tidak konsisten). Ini adalah distorsi makna yang disengaja.
- Cherry-Picking Data: Memilih secara selektif data yang mendukung narasi yang diinginkan dan mengabaikan data yang bertentangan. Ini adalah kegagalan etika dan komunikasi.
- Over-simplification: Terlalu menyederhanakan data kompleks menjadi narasi sebab-akibat yang kaku. Generalisasi yang cacat ini sering terjadi di bab pembahasan skripsi mahasiswa yang mencoba generalisasi temuan.
Pentingnya Komunikasi yang Jujur dan Terbuka
interpretasi yang tuntas membutuhkan kejujuran intelektual. Kegagalan komunikasi sering kali merupakan kegagalan untuk bersikap jujur tentang keterbatasan data. Generalisasi yang berlebihan dalam narasi interpretatif sering kali menjadi bagian tak terpisahkan dari masalah ini. Untuk menghindari kesalahan-kesalahan komunikasi ini, analis harus dilatih dalam visualisasi data yang etis, pengambil keputusan harus memiliki keterampilan literasi data yang lebih baik, dan kejujuran intelektual tentang ketidakpastian data harus menjadi bagian tak terpisahkan dari budaya organisasi, sehingga mengurangi frekuensi generalisasi yang CACAT dalam kesalahan dalam interpretasi data yang merugikan.
Kegagalan Kontekstual: Data Tanpa “Mengapa”
Di luar bias manusia, metodologi yang cacat, rendahnya literasi data, dan kegagalan komunikasi, ada satu penyebab kegagalan interpretasi yang sering diabaikan: kegagalan untuk melihat data dalam konteks yang benar. Interpretasi data yang utuh menuntut batasan yang jelas. Data hanyalah fakta kaku, tetapi interpretasi adalah tentang makna, dan makna selalu bergantung pada konteks.
Mengapa Konteks Itu Penting
Langkah awal dalam kesalahan dalam interpretasi data adalah mengabaikan konteks di mana data tersebut dikumpulkan. Data adalah fakta, tetapi untuk memahaminya, kita perlu tahu “mengapa”. Interpretasi data tidak berhenti pada angka-angka statistik semata. Analis sering gagal menafsirkan data kebangagiaan materi sebagai kebangagiaan psikologis, karena mereka mengabaikan konteks sosial dan budaya. Data penjualan yang tinggi untuk toko mainan di bulan Desember adalah fakta, tetapi makna di balik fakta tersebut hanya bisa dipahami dengan mengetahui konteks musim liburan. Kegagalan melihat konteks ini menyebabkan analis salah mengatribusikan penyebab lonjakan, yang menyebabkan generalisasi yang salah dan keputusan strategi yang salah.
Masalah Kontekstual dalam Interpretasi
Interpretasi data yang baik tidak pernah berdiri sendiri; ia selalu dibangun di atas pemahaman yang kuat tentang konteks. Poin-poin berikut sering diabaikan:
- Data kotor atau tidak terstruktur sering menjadi akar dari analisis yang salah. Kesalahan ini biasanya melibatkan data duplikat, data yang hilang, atau data yang tidak sesuai format. Tanpa pembersihan data yang teliti, interpretasi akan CACAT.
- Bias Ketersediaan: Kecenderungan otak kita untuk Generalisasi Tren berdasarkan data terbaru yang ekstrem, mengabaikan konteks historis yang lebih luas.
- Mengabaikan Variabel Kontrol atau Faktor Pengganggu: Dunia nyata sangat kompleks. Kegagalan mengakui adanya variabel lain dalam bagian keterbatasan penelitian dapat menyebabkan generalisasi yang berlebih, padahal hasil visualisasi data tersebut valid.
Pentingnya Interpretasi Kontekstual yang Utuh
Interpretasi yang benar membutuhkan kedalaman kontekstual. Generalisasi yang cacat sering kali terjadi ketika data dari satu konteks (seperti wilayah atau waktu) diterapkan ke konteks yang berbeda secara tidak kritis. Interpretasi yang jujur menuntut batasan yang jelas. Dengan pemahaman kontekstual yang utuh, kita tidak hanya dapat memahami “mengapa” di balik “berapa”, tetapi juga menciptakan filter yang lebih kuat terhadap generalisasi yang salah. Budaya organisasi harus mendorong analis untuk melakukan interpretasi kontekstual yang lebih kuat, bukan hanya laporan angka yang kering, guna mengurangi frekuensi generalisasi yang CACAT dalam kesalahan dalam interpretasi data yang merugikan.
Baca juga: Format Tabel Analisis Data Skripsi Agar Tidak Salah
Kesimpulan
Sebagai penutup, dunia analisis data bukanlah sekadar tentang angka-angka kaku dan perangkat lunak canggih; itu adalah medan perang antara fakta objektif dan interpretasi manusia yang rawan cacat. Kesalahan dalam interpretasi data adalah kegagalan sistematis yang memiliki konsekuensi nyata, yang sering kali berakar bukan pada datanya sendiri, tetapi pada bagaimana manusia memberinya makna. Melalui penelusuran mendalam dalam artikel ini, kita telah mengupas lima penyebab utama kegagalan interpretasi: bias kognitif manusia yang melekat, metodologi statistik yang CACAT dan disalahgunakan, rendahnya literasi data yang meluas, kegagalan komunikasi yang tidak efektif, serta kegagalan kontekstual yang mendalam.
Memahami mengapa kita sering salah membaca data adalah langkah pertama dan paling krusial untuk mencegah kesalahan dalam interpretasi data di masa depan. Kita tidak bisa sepenuhnya menghilangkan bias manusia atau ketidakpastian data, tetapi kita bisa membangun filter yang lebih kuat dengan kesadaran diri, metodologi yang disiplin, literasi data yang lebih tinggi, komunikasi yang jujur, dan interpretasi kontekstual yang utuh. Generalisasi yang cacat sering terjadi akibat perpaduan penyebab-penyebab utama ini, yang menyebabkan penafsiran yang menyesatkan dan keputusan yang merugikan. Kejujuran intelektual tentang keterbatasan data harus menjadi bagian tak terpisahkan dari budaya organisasi yang autentik.
Untuk menciptakan budaya berbasis data yang Authentik dan tangguh, organisasi harus berinvestasi dalam pelatihan literasi data, mendorong tim untuk berperan sebagai “advokat setan”, dan menciptakan filter yang lebih kuat terhadap generalisasi yang salah. Interpretasi data harus berpijak pada pertanyaan kritis dan interpretasi kontekstual yang kuat. interpretasi data yang jujur menuntut batasan yang jelas. interpretasi data yang tuntas menuntut kejujuran intelektual. Dengan interpretasi yang utuh dan jujur, kita dapat melihat data sebagaimana adanya, bukan sebagaimana kita inginkan, sehingga menciptakan landasan yang lebih kuat untuk pengambilan keputusan berbasis data yang autentik, efektif, dan autentik.
Interpretasi data akan lebih mudah jika kamu memahami konsep dan teliti membaca hasil. Kunci utamanya adalah pemahaman dan latihan. Butuh bantuan? Hubungi Admin Klik Wisuda.
